
Angewandte Bioinformatik und Genomforschung
Forschung
Bevor ein neu sequenziertes Genom für die Forschung nutzbar ist, muss es annotiert werden: Wo liegen die Gene, wie sind sie aus Exons und Introns aufgebaut, welche Funktion haben sie, und welche Abschnitte sind Repeats? Unsere Gruppe entwickelt die Software für diese Schritte und wendet sie in Kooperationen an.
Unsere Arbeit gliedert sich in vier Themen, die aufeinander aufbauen. Die Grundlage ist ein Genfinder, der mit Deep Learning arbeitet. Wir erweitern ihn auf Metagenome, ergänzen die vorhergesagten Gene um Funktionen und annotieren Repeats im selben Modell. Am Ende soll eine einzige, leicht zu installierende Pipeline stehen, die mit der Zahl der Genome im Earth BioGenome Project Schritt hält.
Genomannotation
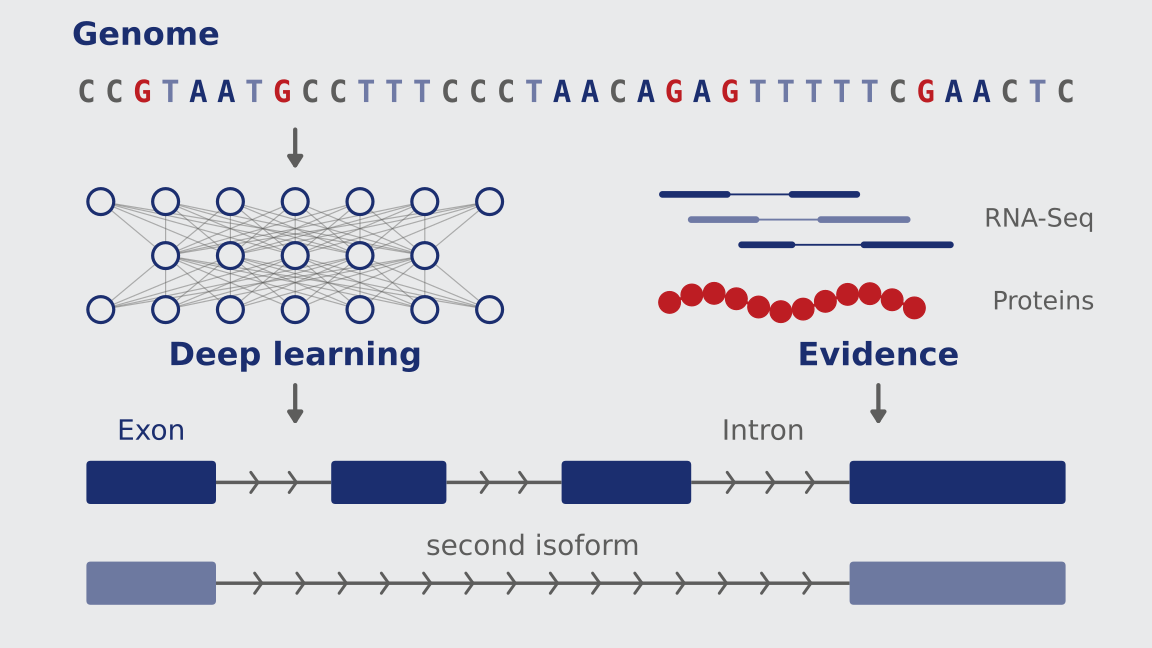
Die Strukturannotation proteinkodierender Gene bestimmt, wo kodierende Exons und Introns liegen. Sie ist die Grundlage für Funktionsannotation und Evolutionsanalysen. Lange beruhte sie auf Hidden-Markov-Modellen wie AUGUSTUS und GeneMark. Diese müssen für jede neue Art trainiert werden und werden erst mit zusätzlichen Daten aus Transkriptomen oder Proteindatenbanken genau.
Mit den Pipelines BRAKER1, BRAKER2, BRAKER3 und BRAKER4 haben wir dieses Training automatisiert. Galba und GALBA2 nutzen den schnellen Protein-Aligner miniprot, um Trainingsgene und Hinweise aus Proteinsequenzen zu gewinnen. Tiberius ist ein Genfinder, der Deep Learning mit einer trainierbaren HMM-Schicht verbindet. Im menschlichen Genom erreicht er ohne zusätzliche Evidenz die Genauigkeit von BRAKER3 bzw. BRAKER4, und ein Säugetiergenom annotiert er in etwa zwei Stunden auf einer einzelnen GPU.
Im DFG-Projekt AI-GUSTUS erweitern wir Tiberius und Vipsania um Evidenz aus Transkriptom- und Proteindaten und um die Vorhersage alternativer Spleißvarianten. Diese neue Pipeline heißt Paludamentum und bildet den Mantel um in Kooperation mit der AG von Prof. Mario Stanke entwickelte Deep Learning Gene Finder. Die Software ist quelloffen, in Nextflow und Python geschrieben und läuft in Containern auf HPC-Clustern und in der Cloud.
Eukaryotische Metagenomik
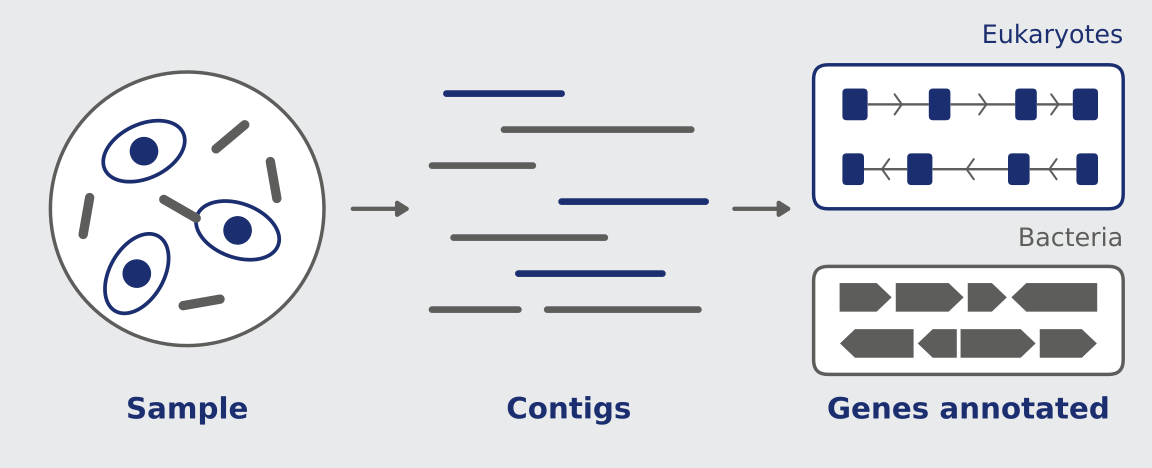
Viele ökologisch wichtige Eukaryoten kennen wir nur aus Umweltproben. In Metagenomen lassen sich ihre Sequenzen oft nicht zu vollständigen Genomen zusammensetzen. Die üblichen Arbeitsabläufe stammen aus der Prokaryotenforschung und scheitern an den komplexeren Genstrukturen und den vielen Repeats der Eukaryoten. Unvollständige Bins und einzelne Contigs bleiben deshalb meist ohne Annotation.
Wir entwickeln einen skalierbaren Snakemake-Workflow für eukaryotische Sequenzen in Metagenomen. Er verbindet etablierte Werkzeuge mit solchen, die eigens für Eukaryoten gebaut wurden, zum Beispiel mit dem Deep-Learning-Genfinder Vipsania (Krieg et al., 2026). Wir untersuchen außerdem, wie sich Metatranskriptom-Daten mit geringer Abdeckung nutzen lassen und ob ein Foundation-Modell die taxonomische Einordnung einer Sequenz gleich mitliefern kann.
Wir testen die Methoden an zwei Arten von Proben. Die einen sind Long-Read-Metagenome von Phytoplanktonblüten in der Nordsee, in Zusammenarbeit mit der Greifswalder Forschung zur Verwertung mariner Polysaccharide (POMPU). Die anderen sind Pansenmetagenome von Milchkühen, die im Verbund Alg4Nut mit Algen gefüttert werden. Dort geht es vor allem um die Protisten und Pilze im Pansen.
Funktions- und Repeat-Annotation
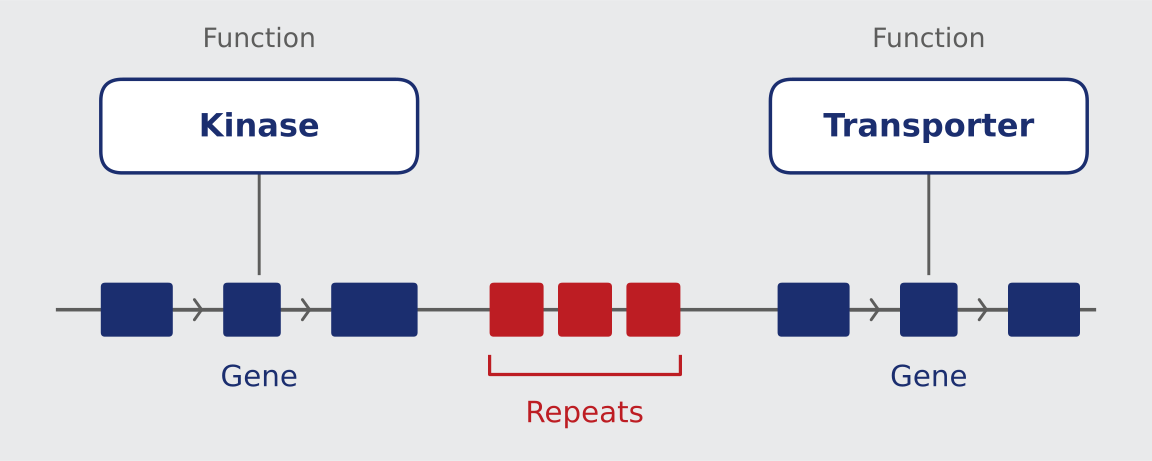
Eine Genomannotation ist erst vollständig, wenn die Gene eine Funktion tragen und die Repeats beschrieben sind.
Deep-Learning-Werkzeuge wie FANTASIA (Martinez-Redondo et al., 2025) ordnen Proteinen GO-Terme deutlich schneller und häufiger zu als ältere Verfahren. Für die Einreichung bei GenBank oder ENA braucht aber jedes Gen einen Produktnamen, der strengen Regeln folgt. Gemeinsam mit dem FANTASIA-Team arbeiten wir an einem Modul, das aus GO-Vorhersagen gültige Produktnamen ableitet, und binden die Funktionsannotation in unsere Pipeline ein. So sollen weniger Gene als "hypothetical protein" enden.
Für die Repeat-Annotation braucht der heutige Standard aus RepeatModeler2 und RepeatMasker für ein Säugetiergenom teils mehr als 72 Stunden. Wir erweitern die Architektur von Tiberius so, dass das Modell Gene und häufige Repeat-Klassen gleichzeitig vorhersagt. Außerdem prüfen wir, ob sich artspezifische Repeats mit einem Genom-Foundation-Modell erkennen lassen.
Angewandte Bioinformatik
Wir bringen unsere Methoden in biologische Projekte ein. Dazu gehören Genomassemblierung und Annotation, Beratung bzgl. Transkriptomanalysen und populationsgenomischer Auswertungen.
Einige Beispiele: Wir haben 49 Kieselalgen-Genome mit einem einheitlichen Arbeitsablauf annotiert und annotieren aktuell hunderte Vertebratengenome mit Deep Learning und Evidenz. In der Infektionsforschung haben wir zur Analyse der weltweiten Ausbreitung von Klebsiella pneumoniae ST395 und zu Arbeiten über Streptococcus pyogenes beigetragen. Im BMBF-Projekt AI-Biome entwickelten wir Methoden, um Krankheitserreger in der Umgebung von Milchviehbetrieben früh zu erkennen.
Wir arbeiten an internationalen Standards mit: im Annotationsausschuss des Earth BioGenome Project, im European Reference Genome Atlas (ERGA), und im wissenschaftlichen Beirat von OrthoDB.
Drittmittelprojekte
Heisenberg-Professur
Die DFG fördert unsere Abteilung mit einer Heisenberg-Professur (Projektnummer 567443876). Wir entwickeln ein Softwaresystem für die Genomannotation, das auf Genom-Foundation-Modellen aufbaut und mit den Millionen Genomen des Earth BioGenome Project mithalten kann. Es soll Genstrukturen, Genfunktionen und Repeats in einem Durchlauf annotieren, auch in Metagenomen mit einzelligen Eukaryoten. Bei der Funktionsannotation arbeiten wir mit Ana Rojas (CABD Sevilla) und Rosa Fernández (Metazoa Phylogenomics Lab, IBE Barcelona) zusammen, bei der Repeat-Annotation mit Shujun Ou (Ohio State University) und Lukas Schrader (Universität Münster).
AI-GUSTUS
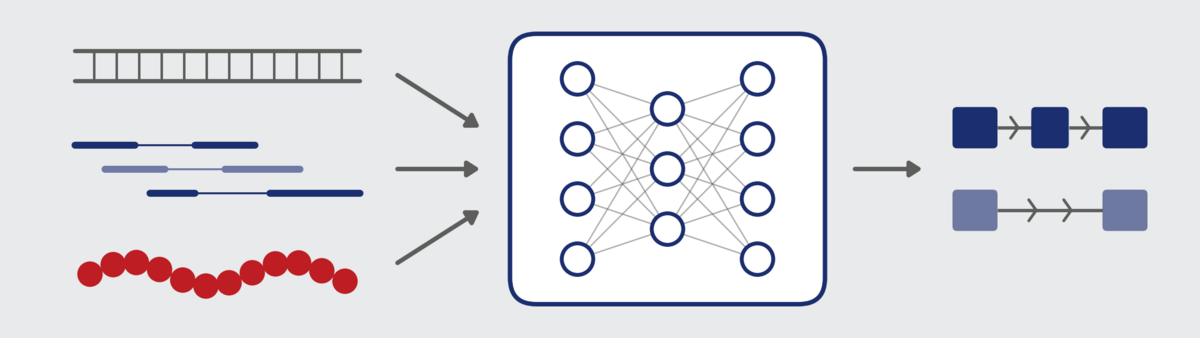
AI-GUSTUS ist ein DFG-Projekt (Projektnummer 552910312, 2024 bis 2026). Wir bauen den Genfinder Tiberius zu einer Pipeline aus, die Transkriptom- und Proteindaten als Evidenz nutzt, alternative Spleißvarianten vorhersagt und in der Cloud läuft. Unsere Partner sind Mario Stanke (Bioinformatik, Universität Greifswald) und Tomas Bruna (DOE Joint Genome Institute).
Alg4Nut
Alg4Nut untersucht, wie Algen aus küstennahem Anbau als Futterzusatz auf das Pansenmikrobiom von Milchkühen wirken und ob sie den Methanausstoß senken. Den Verbund leitet Prof. Dr. Mirko Basen (Mikrobiologie, Universität Rostock). Er wird aus dem Europäischen Fonds für regionale Entwicklung (EFRE) des Landes Mecklenburg-Vorpommern gefördert und läuft von April 2025 bis März 2029. Wir sind assoziierter Partner im Teilprojekt von Prof. Dr. Dörte Becher (Mikrobielle Proteomics, Universität Greifswald). Dort annotieren wir die Genome von Protisten und Pilzen aus Pansenmetagenomen, damit die Metaproteomik deren Proteine erkennt. Mehr steht auf der Projektseite von Alg4Nut.
TRR 420 CONCENTRATE: A6 HOME
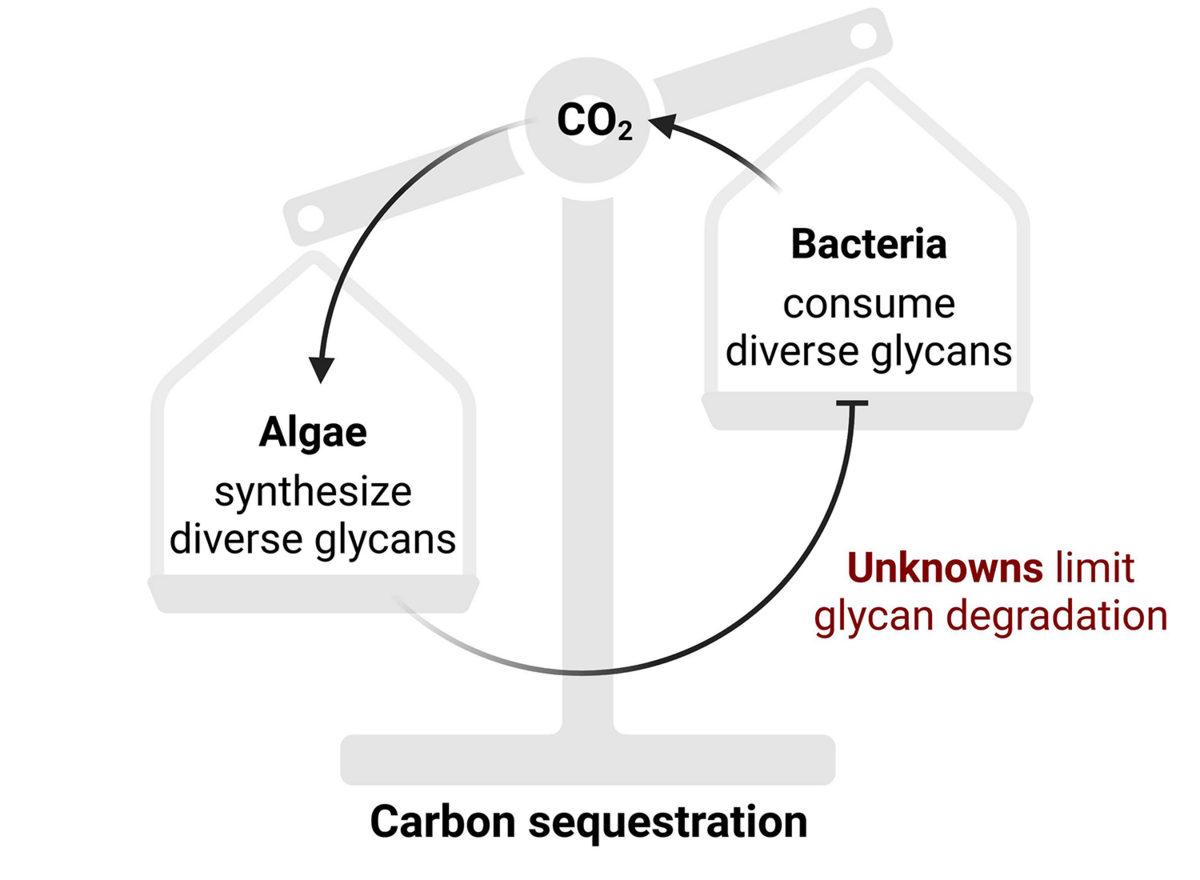
Der Sonderforschungsbereich TRR 420 CONCENTRATE der Universitäten Greifswald und Bremen untersucht, warum Zucker aus Meeresalgen (Glykane) im Ozean lange erhalten bleiben und so Kohlenstoff binden. Die DFG fördert ihn seit 2025. Im Teilprojekt A6 HOME arbeiten wir mit Dr. Mia Bengtsson (Küstenmikrobiome, Universität Greifswald) zusammen. HOME prüft die Annahme, dass Algen komplexe Glykane bilden, um sich gegen manche Bakterien zu schützen und andere zu fördern. Wir entwickeln dafür Methoden für eukaryotische Sequenzen aus Umweltproben und annotieren die Genome von Algen und photosynthetischen Protisten, um zu verstehen, wie diese Organismen Glykane herstellen.
GEvol
GEvol ist das DFG-Schwerpunktprogramm 2349 zu den genomischen Grundlagen evolutionärer Innovationen. Darin bearbeiten wir mit Erich Bornberg-Bauer (Universität Münster) und Gregor Bucher (Universität Göttingen) das Projekt "Funktionale Annotation von genomischen Innovationen in einer phylogenetisch dicht besetzten Klasse mit Hilfe von Deep Learning" (Projektnummer 503348080, zweite Förderphase). Wir entwickeln Deep-Learning-Methoden, die neue Gene in Insektengenomen finden und ihnen Funktionen zuordnen. Wir testen sie an De-novo-Genen, also Genen, die aus zuvor nicht kodierender DNA entstanden sind.
Webserver
Auf unserem Webserver lassen sich tools wie Tiberius und AUGUSTUS ohne Installation im Browser nutzen. Wir betreiben ihn gemeinsam mit der Arbeitsgruppe von Prof. Dr. Mario Stanke.
Software
Unsere Software ist quelloffen und frei verfügbar. Wir entwickeln sie in enger Zusammenarbeit mit der Arbeitsgruppe von Prof. Dr. Mario Stanke und veröffentlichen sie gemeinsam in der GitHub-Organisation Gaius-Augustus.
- Tiberius: Genfinder mit Deep Learning und HMM-Schicht, annotiert ein Säugetiergenom in etwa zwei Stunden auf einer GPU.
- Paludamentum: Nextflow-Pipeline, die die proteinkodierenden Gene eines eukaryotischen Genoms annotiert. Sie verbindet die Ab-initio-Vorhersagen der Deep-Learning-Genfinder Tiberius und Vipsania mit Evidenz aus Proteinen, RNA-Seq und Iso-Seq zu einem Gensatz mit alternativen Isoformen, UTRs und einem Qualitätsbericht.
- BRAKER4: vollautomatische Genomannotation mit RNA-Seq- und Protein-Evidenz, mit GeneMark-ETP, AUGUSTUS und TSEBRA, inkl. nachgelagerter Qualitätskontrolle.
- BRAKER: vollautomatische Genomannotation mit RNA-Seq- und Protein-Evidenz, mit GeneMark-ETP, AUGUSTUS und TSEBRA (die ursprüngliche Perl-Pipeline).
- GALBA2: Genomannotation mit miniprot und AUGUSTUS, wenn nur Proteine verwandter Arten vorliegen, inkl. nachgelagerter Qualitätskontrolle.
- Galba: Genomannotation mit miniprot und AUGUSTUS, wenn nur Proteine verwandter Arten vorliegen (die ursprüngliche Perl-Pipeline).
- TSEBRA: wählt aus mehreren Genvorhersagen die Transkripte aus, die am besten durch Evidenz gestützt sind.
- Scribonia: bestimmt allein aus der DNA, welche der Codons TAA, TAG und TGA in einem Genom oder Metagenom-Bin als Stoppcodons dienen, in etwa einer Sekunde pro Megabase.
- MakeHub: erzeugt automatisch Assembly Hubs für den UCSC Genome Browser.
- pyVARUS: Python-Implementierung von VARUS, lädt gezielt RNA-Seq-Reads aus dem Sequence Read Archive, die sich ergänzen, und aligniert sie.
Schulungsmaterial zur Genomannotation: Workshop on Genomics, Český Krumlov und BRAKER- und TSEBRA-Workshop für ERGA. Material für Data-Science-Kurse: Data Competency.
Kontakt
Prof. Dr. Katharina Hoff
Angewandte Bioinformatik und Genomforschung
Institut für Mikrobiologie
Center for Functional Genomics of Microbes (C_FunGene)
Felix-Hausdorff-Straße 8, Raum 0.63
17489 Greifswald
Germany
Telefon: +49 (0)3834 420 4624
E-Mail: katharina.hoff[at]uni-greifswald.de